Нейросеть тормозит на Mac: где теряется время
Долгая пауза перед первым словом и медленный ответ — разные проблемы. Разбираемся, что проверить в каждом случае.
- Автор
- provod.ai
- Опубликовано
- Обновлено
- Категория
- Гайды
- Время чтения
- Чтение: 7 мин

Вы задали короткий вопрос, а Mac молчит. Или ответ начался сразу, но каждое новое слово приходится ждать. На экране это выглядит как одна проблема — «нейросеть тормозит», хотя причины могут быть разными. Разберёмся, где проходит время и что проверить, прежде чем менять программу или компьютер.
Измеряйте этапы отдельно: общий таймер не показывает причину задержки.
Речь о модели, которая запущена на вашем Mac. Если вы общаетесь с облачным сервисом через браузер, ответ готовит другой компьютер: показатели памяти вашего ноутбука не объяснят всю задержку. Для локальной работы начнём с трёх этапов, которые легко различить по поведению программы.
Где проходит время до готового ответа
Сначала программа загружает модель в память — примерно как большое приложение при запуске. Затем читает ваш запрос и приложенные материалы. Только после этого она начинает выдавать ответ небольшими частями — токенами. Токен может быть словом или его частью; в технической документации скорость обычно считают именно в них.
На экране всё может выглядеть как одна пауза, но поведение различается. Если долго только первое обращение, стоит проверить загрузку. Если короткий вопрос обрабатывается быстро, а большой документ вызывает долгую паузу до первого слова, интересен входной контекст. Если ответ начинается скоро, но текст появляется медленно, нужно смотреть генерацию.
Это рабочие направления проверки, а не диагноз по одному признаку. Приложение может дополнительно обращаться к поиску, читать файлы и ждать внешних инструментов. Тогда время всей задачи будет больше времени, которое потратила сама модель.
Проверьте память и размещение модели
В «Мониторинге системы» на Mac откройте вкладку «Память». Apple предлагает смотреть показатель нагрузки на память и сведения о подкачке, а не только число свободных гигабайт. Руководство Apple.
Если при работе с моделью заметно меняется нагрузка и растёт использование подкачки, это повод сравнить меньший вариант модели или более короткий контекст. Меняйте один параметр за раз, чтобы видеть его влияние. Сам по себе большой файл подкачки ещё не доказывает причину конкретной задержки.
Если вы пользуетесь Ollama — программой для локального запуска моделей, — команда ollama ps покажет загруженные модели. В столбце PROCESSOR можно проверить, размещена ли модель на центральном процессоре (CPU), графическом процессоре (GPU) или в обоих. Расшифровка вариантов приведена в FAQ Ollama.
Не переносите сюда настройки NVIDIA из инструкции для другого компьютера. На Apple Silicon важны собственная среда запуска, модель и доступная общая память. Сначала установите фактическую конфигурацию, затем выбирайте изменение.
Если нужны точные замеры: пример для Ollama
Через программный интерфейс Ollama, API, можно получить отдельные счётчики загрузки, чтения запроса и ответа. Этот раздел пригодится тем, кто уже пользуется Ollama и готов открыть терминал. Для первого шага достаточно проверок памяти и поведения программы из предыдущих разделов. Поля ответа Ollama.
| Поле ответа | Что показывает | Для какой проверки полезно |
|---|---|---|
load_duration | Время загрузки модели | Различие первого и повторного обращения |
prompt_eval_count | Количество входных токенов | Сопоставимость запросов |
prompt_eval_duration | Время обработки входного текста | Задержка на длинном контексте |
eval_count | Количество созданных токенов | Объём выполненной генерации |
eval_duration | Время создания токенов | Скорость выпуска ответа |
Таблица: поля Ollama, используемые для раздельного наблюдения этапов.
Откройте терминал и посмотрите доступные модели командой ollama list. Для запроса ниже замените MODEL_NAME на точное имя уже установленной текстовой модели:
curl http://localhost:11434/api/generate \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "MODEL_NAME",
    "prompt": "В трёх предложениях объясни, зачем сохранять резервные копии.",
    "stream": false,
    "options": {"num_predict": 128}
  }' > timing.json
Ответ сохранится в timing.json. Временные значения указаны в наносекундах. Чтобы получить скорость генерации в токенах в секунду, разделите eval_count на eval_duration / 1 000 000 000. Эта скорость относится к выпуску текста, а не ко всему ожиданию пользователя.
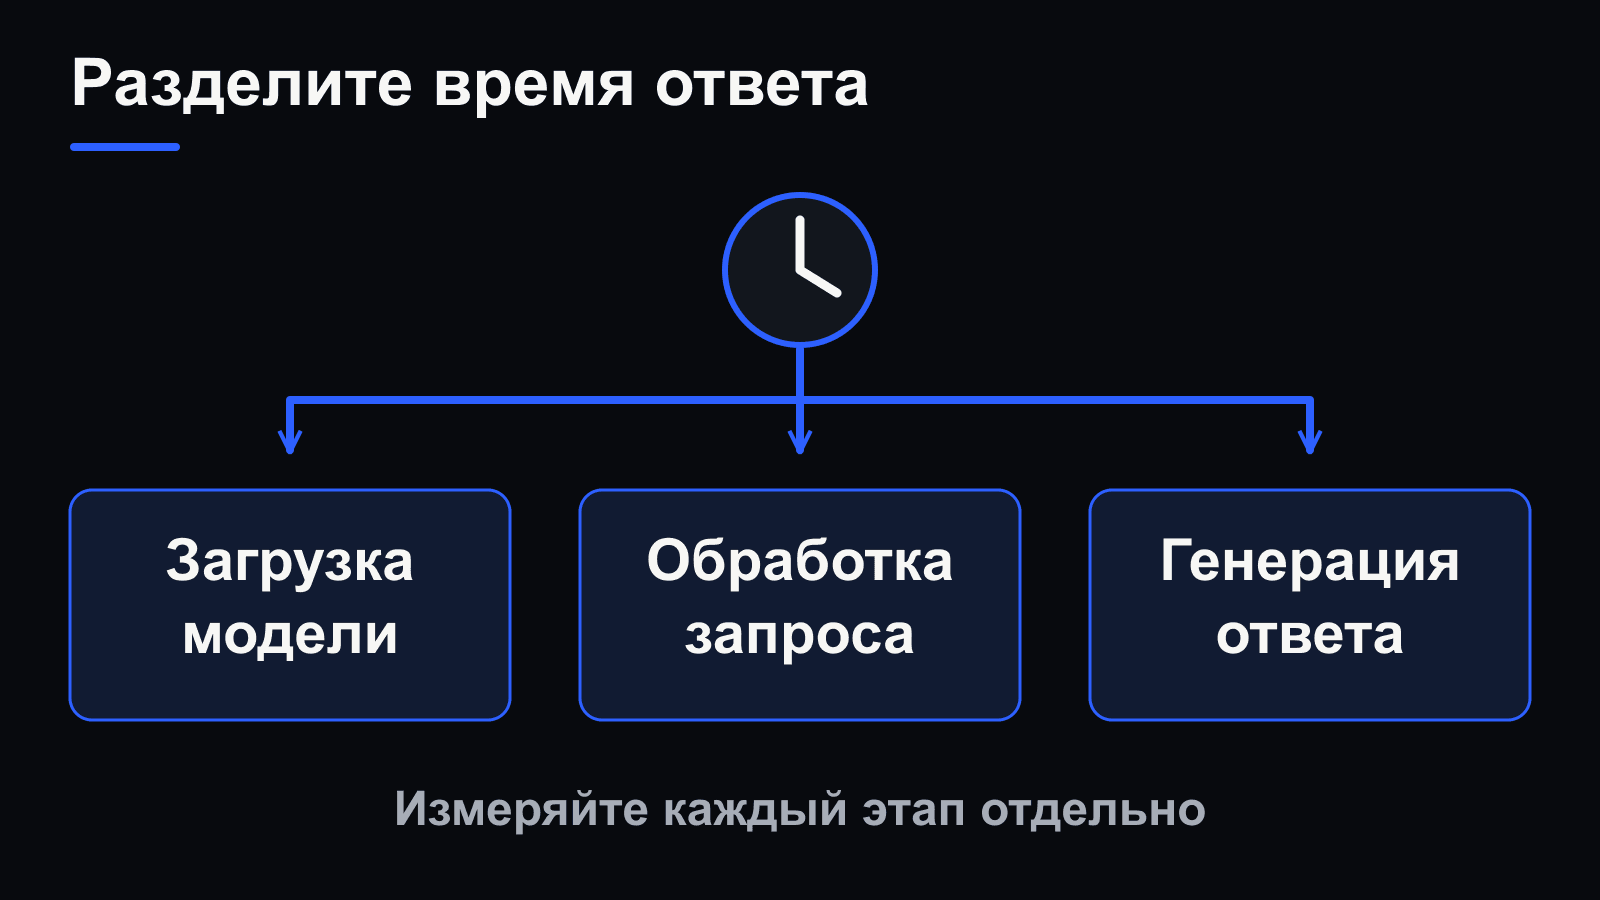
В Ollama этапам соответствуют load_duration, prompt_eval_duration и eval_duration. Сопоставляйте их на одинаковых запросах; схема не содержит замеров производительности.
Сравнивайте одинаковые условия
Сначала повторите один короткий запрос несколько раз с той же моделью и настройками. Отдельно сохраните первый результат: он может включать загрузку. Затем попробуйте более длинный вход и посмотрите, какой показатель изменился.
Не стоит сравнивать короткий ответ одной модели с длинным рассуждением другой только по времени завершения. Количество созданного текста и режим работы могут отличаться. Рядом со временем запишите название модели, длину запроса и размер ответа. Иначе более короткий ответ легко принять за более быструю работу.
Если задача состоит из цепочки обращений, проверьте и саму цепочку. Помощник может быстро отвечать на каждый запрос, но делать много лишних шагов. Это другая проблема, чем медленная генерация одного ответа.
Для сравнения с облачной моделью можно взять тот же материал и критерий качества в provod.ai. Оценивайте весь полезный результат: время ожидания, правильность ответа и необходимость исправлений. Такое сравнение помогает выбрать рабочий вариант, но не измеряет чистую производительность вашего Mac.
Что объясняет tiny-llm
Если хочется понять причины глубже, есть открытый учебный проект tiny-llm. В нём участник собирает собственный небольшой движок для Apple Silicon — компьютеров Mac с чипами Apple. Так можно увидеть, на что уходят вычисления. Это обучение устройству модели, а не готовая настройка, которая ускорит установленную Ollama.
Например, в главе о KV-кэше изучается повторное использование уже вычисленных данных внимания. Вместо обработки всего предыдущего текста на каждом шаге движок сохраняет нужное состояние и продолжает с новым токеном. Это механизм внутри генерации; его не следует смешивать со скидкой провайдера за повторяющееся начало API-запроса. Глава Cache and Measure.
Курс помогает связать изменение кода с тем, что происходит на экране и в замерах. Он рассчитан на разработчиков, готовых работать с Python, C++ и Metal. Некоторые учебные этапы отмечены как находящиеся в доработке: перед выбором главы нужно смотреть текущую карту курса, а не обещать себе законченный производственный сервер.
Когда стоит идти в устройство движка
Если нужен быстрый результат для одной рабочей задачи, сначала достаточно проверить размер модели, контекст, размещение и повторяемые измерения. Эти наблюдения уже позволяют обсуждать проблему предметно.
Курс пригодится, когда вы разрабатываете собственный запуск моделей или хотите понимать, почему конкретная оптимизация помогает одному режиму и не помогает другому. В подготовке окружения указаны Apple Silicon, PDM и инструменты сборки. Для первого учебного пути используется небольшой вариант Qwen3; более крупные модели требуют отдельной оценки памяти.
Хороший итог диагностики — не просто новое число скорости. Это понятное объяснение задержки и изменение, которое улучшило нужный режим, сохранив качество ответа. С таким результатом уже можно выбирать между настройкой программы, другой моделью и переходом части задач в облако.